Investigación en Psicología
StatSimPro
De una idea difusa a una tesis defendible.
Encuentra temas y problemáticas, explora antecedentes, trabaja con datos y obtén análisis y resultados que te ayuden a avanzar en tu investigación de principio a fin — gratis y 100 % en tu navegador.
🔭 Explora problemáticas🔎 Busca antecedentes🎲 Genera bases de datos📊 Analiza y exporta en Word APA 7
01 · Explora
Descubre qué investigar
Cruza las noticias del mundo con la producción académica y encuentra problemáticas latentes: mucho ruido mediático, pocos antecedentes. Ahí vive tu tesis.
02 · Busca
Todos tus antecedentes, un solo lugar
Búsqueda simultánea con variantes generadas por IA, criba con criterios de inclusión y relevancia, y una matriz con referencias APA lista para el marco teórico.
03 · Simula y analiza
Datos que se entienden
Genera bases sintéticas reproducibles o carga las tuyas: descriptivos, normalidad, correlación con protocolo automático, regresión, comparación de grupos y SEM — cada resultado explica su porqué.
04 · Defiende
Capítulos en Word APA 7
Marco teórico y resultados con tablas y figuras numeradas, exportados en .docx — gratis y 100 % en tu navegador: tus datos nunca salen de tu equipo.
Sin registro · Sin instalación
Para tesis de psicología
Exploradorde Problemáticas
Escribe un tema que te interese y descubre dónde hay una tesis esperándote: StatSim Pro cruza las noticias del mundo con la producción académica y te muestra qué problemáticas suenan fuerte pero aún tienen pocos estudios — con un mapa mundial para explorar por país.
Para tesis de psicología
Generadorde Datos
Diseña tu instrumento — pruebas, escalas, ítems — y genera en segundos una base de datos sintética y reproducible para practicar todo el flujo de análisis sin arriesgar datos reales. Expórtala, o pásala directo al Analizador con un clic.
Configuración General
Control_1…): los atentos aciertan y los descuidados fallan. Sirve para practicar la depuración por atención: quien falla el control se descarta.
Tiempo_respuesta_seg con lo que tardó cada persona en responder; los descuidados tardan mucho menos. Sirve como criterio de depuración: los tiempos demasiado cortos se descartan.
I. Pruebas Aplicadas
| Prueba (test) | Variable psicológica que mide | Dimensiones (separadas por coma) | r entre dimensiones | Acciones |
|---|
| Prueba (test) | Escala / Dimensión | N° de Ítems | Distribución | Media (M) | Desviación Estándar (DE) | Mín por Ítem | Máx por Ítem | α objetivo | Ítems inv. | Dificultades | Acciones |
|---|
Guía de cada campo:
- Prueba (test): se elige del desplegable, que se alimenta del cuadro Pruebas del estudio situado sobre la tabla (donde se declara cada instrumento y la variable psicológica que mide). Varias filas con la misma prueba quedan agrupadas como sus dimensiones, y el sistema añade sola la columna General_ con el promedio de todas ellas. Si la prueba tiene una sola fila, es unidimensional: esa escala es su variable general (columna General_).
- Escala / Dimensión: nombre de la subescala o dimensión de esa prueba (Ej: "Memoria de trabajo", "Atención"). Cada fila representa UNA escala con sus propias medidas (ítems, rango, Media, DE). La sigla del nombre de la escala se usa para nombrar sus ítems en la base (Ej: "Memoria de trabajo" → MDT1, MDT2, … y su total Dimension_MDT, o General_MDT si es la única escala de su prueba). Si dos escalas tienen las mismas iniciales, la segunda alarga su sigla con letras, nunca con números (Intrapersonal → I1, I2…; Interpersonal → IN1, IN2…).
- Tipo — Dimensión o General: Dimensión es una subescala con sus propios ítems. General es la escala general del test, obligatoria y única por prueba: en "Escala" escribe el nombre de la variable que el test pretende medir (Ej: "Inteligencia emocional"). La escala general es una sola columna de datos, por eso NO lleva N° de ítems ni α (se desactivan); su Mín y Máx son de la escala general completa, no por ítem, y su Media y DE describen ese puntaje general. Aunque un test no tenga dimensiones, siempre lleva su fila General.
- N° de ítems: cantidad de ítems (preguntas) de ESA escala, según la ficha técnica. Fijo a priori e invariable de aplicación en aplicación.
- Mín / Máx por ítem: rango de valores posibles de cada ítem individual de esa escala (Ej: Likert 0–5, 1–7). Obligatorios y fijos según la ficha técnica; determinan el rango alcanzable del puntaje directo de la escala: desde N° de ítems × Mín hasta N° de ítems × Máx.
- α objetivo (opcional): fiabilidad deseada de la escala (0–0.99): la proporción de la puntuación total que refleja el constructo y no el error de medida. Con un valor (Ej: 0.85) los ítems comparten un factor común y la escala alcanzará aproximadamente esa fiabilidad en el índice elegido arriba —α de Cronbach u ω de McDonald—; el generador se autocalibra para que el valor observado coincida con el solicitado. Vacío o 0 = ítems independientes.
- Ítems invertidos (opcional): número de ítems de la escala que se puntúan al revés (serán los últimos). La base los entrega sin recodificar, tal como llegan de un cuestionario real: antes de sumar o de calcular la fiabilidad hay que reflejarlos (mín + máx − valor). El diccionario del Analizador los marca como «INVERTIDO».
- Distribución: forma del puntaje directo de la escala. Normal = campana (necesaria para análisis paramétricos como Pearson); Uniforme = plana; Asimétrica = con cola positiva (efecto suelo, típico de escalas clínicas).
- Media (del puntaje DIRECTO de la escala): promedio esperado del puntaje directo de la escala (la suma de sus ítems en cada participante), no de los ítems individuales. Regla de coherencia: como es una suma, la Media solo puede estar entre N° de ítems × Mín y N° de ítems × Máx; la página calcula ese rango en vivo y no permite valores fuera de él. (Ej: si el Mín por ítem es 1, la Media nunca puede ser menor que el número de ítems.)
- Desviación estándar (del puntaje DIRECTO): dispersión esperada de los puntajes directos de la escala alrededor de su Media (no por ítem). Una DE pequeña indica que la mayoría puntuará cerca del promedio. (Ej: "quiero que los puntajes se dispersen ±12 puntos" → DE = 12.) Su rango recomendado tiene máximo (evita el recorte contra los topes) y mínimo según N (evita que la suma de enteros salga "escalonada").
- ¿Cómo se usan Media y DE juntas? Si colocas Media = 80 y DE = 12, le dices al programa: "quiero que el puntaje directo de ESTA escala tenga media 80 y desviación estándar 12". No significa "cada ítem con media 80".
- Puntaje directo vs. puntaje escalar: aquí siempre configuras el puntaje directo (suma cruda de ítems). Los puntajes escalares o convertidos (CI = 100±15, puntuaciones T = 50±10, eneatipos, etc.) son transformaciones por baremos y NO corresponden a la suma de ítems: no uses esos valores como Media/DE aquí.
- Qué genera el programa por cada persona encuestada (en este orden de columnas): (a) los ítems de cada dimensión (Ej: MDT1…MDT15); (b) los puntajes directos de las dimensiones = suma de sus ítems (Total_MDT, Total_CV, …); (c) al final, el puntaje de la Escala general de cada prueba (Total_IE); y (d) opcionalmente, si activas la casilla "Generar percentiles" en Configuración General, los percentiles de cada puntaje (PC_…, en el mismo orden: dimensiones y luego generales): la posición relativa de esa persona dentro de la muestra generada (0–100).
II. Datos Sociodemográficos
| Categoría | Distribución | Promedio | Desviación Estándar | Mínimo | Máximo | N° Decimales | Categorías / opciones | Depende de · fuerza | Acciones |
|---|---|---|---|---|---|---|---|---|---|
Distribución: Normal y Asimétrica usan Promedio y DE;
Uniforme y Categórica usan Mín/Máx (la categórica genera niveles enteros
equiprobables); Conteo (Poisson) usa el Promedio como tasa; Binaria usa el
Promedio como proporción de unos (p. ej. 0.5). Mín/Máx: rango de valores.
Decimales: precisión (0-4).
Categorías / opciones: en binarias y categóricas, los nombres de las categorías separados por coma
(«Femenino, Masculino»; la binaria codifica 0 la primera y 1 la segunda), con proporciones si las quieres
(«Soltero:60, Casado:30, Divorciado:10») o en orden si es ordinal («Primaria < Secundaria < Superior»). En modo
exacto las proporciones salen exactas en la muestra. La base y el CSV muestran los nombres; el motor y las pruebas
estadísticas trabajan con los códigos. En una variable continua que sea una edad, «fecha» (o «fecha:AAAA-MM-DD»)
añade la columna FechaNac_… con una fecha de nacimiento coherente con la edad a esa fecha.
Depende de: hace que una binaria o categórica esté asociada a otra (p. ej. Grado según Zona) con la
fuerza indicada; el informe muestra la V de Cramér obtenida. Para que una variable continua difiera según un grupo,
usa la tabla IV.
III. Correlaciones Objetivo (opcional)
| Variable A (X) | Variable B (Y) | r, o fuerza η | Tipo de relación | Nube | Acciones |
|---|
Tipo de relación (según el Atlas de relaciones entre variables): con «Lineal», el número es la r de Pearson, con signo. Con una forma no lineal —logarítmica, sigmoide, U, cíclica…—, B depende de A a través de esa curva y el número es la fuerza η (0 a 0.97), la correlación entre B y la curva; la r de Pearson saldrá la que implique la forma (cerca de 0 en una U aunque la relación sea fuerte). La curvatura se aprecia mejor si A tiene distribución uniforme.
Define la correlación deseada entre dos variables cuantitativas (totales de escala o sociodemográficas continuas: Normal/Asimétrica). El generador construye los datos para que la correlación observada se acerque a la pedida (corrige la atenuación por la fiabilidad de las escalas). Para escalas, usa un α objetivo > 0. Sin filas = variables independientes.
IV. Diferencias por Grupo (opcional)
| Tipo de efecto | Variable cuantitativa | Variable de agrupación | × Segunda agrupación | d / CCI | Acciones |
|---|
Hace que la media de una variable cuantitativa difiera según una variable de agrupación (Binaria o Categórica), con el tamaño del efecto (d de Cohen) indicado. Alimenta la comparación de grupos (t / ANOVA). Sin filas = sin diferencias. Interacción A × B (dos binarias): la diferencia entre grupos de A cambia según B en la d indicada (diseño factorial 2×2, ANOVA de dos factores); los efectos principales se piden aparte, en sus propias filas. Anidamiento (CCI): la variable se parece más dentro de cada grupo de una categórica (aulas, colegios) que entre grupos, con la correlación intraclase indicada (modelos multinivel); con menos de ocho grupos la CCI estimada fluctúa mucho.
V. Modelos Estructurales: mediación, moderación y terceras variables (opcional)
| Modelo | X (predictora) | Mediador M / Moderador W / Tercera variable Z / Grupos | Y (criterio) | Coef. 1 | Coef. 2 | Coef. 3 | Acciones |
|---|
Coeficientes estandarizados. Mediación X → M → Y: a (X→M), b (M→Y controlando X) y c′ (X→Y directo); el efecto indirecto es a·b y el total c′ + a·b. Dos filas con la misma X e Y y distinto mediador forman una mediación paralela. Curvilínea Y = β₁X + β₂X²: relación en U (β₂ > 0) o U invertida (β₂ < 0), con X estandarizada; el informe la recupera con una regresión sobre X y X². Moderación Y = β₁X + β₂W + β₃·X·W: la interacción se construye con X y W estandarizadas, tal como la estimará una regresión con el término producto; la forma de Y la define el modelo (normal). Terceras variables (Z en la columna del mediador; se piden r(Z,X), r(Z,Y) y la relación verdadera de X con Y): en la confusión, Z causa X e Y y la relación verdadera es la parcial (con 0, la de orden cero es espuria); en la supresión, Z se relaciona con X y no con Y, y controlarla aumenta la relación; en el colisionador, X e Y causan Z, la verdadera es la de orden cero y controlar Z crea una relación que no existe (si además se selecciona la muestra por Z, con la selección por rango, aparece la paradoja de Berkson). El informe verifica las tres correlaciones y la parcial. Paradoja de Simpson (los grupos en la columna central: una variable binaria o categórica de los sociodemográficos): se pide la r de X con Y dentro de los grupos y la d de Cohen de X y de Y entre ellos (con más de dos grupos, por unidad de código: la diferencia entre grupos consecutivos, como en la tabla de diferencias); si las dos d van en un sentido que contradice la r de dentro y son grandes, la relación se invierte al juntar los grupos (por ejemplo, +0,40 dentro y −0,10 en toda la base, con d de 1,5 y −1,5). El informe verifica la r dentro de cada grupo, la combinada, la de toda la base y las dos d. Las correlaciones que implican los coeficientes sustituyen a las de la tabla III para esas parejas; el informe «pedido vs. obtenido» muestra cada coeficiente recuperado por regresión sobre la base generada.
VI. Medidas Repetidas: pre/post y seguimiento (opcional)
| Escala | Ondas | Estabilidad (r) | d de cambio | Agrupación | d de cambio (grupo 1) | Modelo | DE pendientes | r nivel–pendiente | Acciones |
|---|
Repite una escala en 2 a 4 ondas. La onda 1 conserva sus columnas; las siguientes añaden ítems, total y percentil con
sufijo _T2, _T3… (mismo instrumento: mismo α, forma y perfil de ítems). La
estabilidad es la correlación entre ondas consecutivas (entre no consecutivas decae como en un
proceso AR(1)); las correlaciones de la escala con otras variables se propagan a cada onda atenuadas por ella (con interceptos aleatorios, la estabilidad es la misma entre cualquier par de ondas y esas correlaciones son iguales en todas).
La d de cambio desplaza la media de T1 a la última onda en DE de T1, de forma lineal entre ondas;
con una agrupación binaria cada grupo cambia lo suyo (diseño pre/post con grupo control) y el informe
muestra el cambio por grupo y la interacción tiempo × grupo. Con el modelo de crecimiento, cada persona tiene su pendiente (con la DE indicada, en DE de T1) y una correlación nivel–pendiente; la DE de las ondas crece y las correlaciones entre ondas las implica el modelo (con tres ondas o más se ajusta un modelo de curva de crecimiento). Las diferencias por grupo de la tabla IV se mantienen en
todas las ondas; los puntajes generales derivados y los modelos usan solo la onda 1.
Relación entre personas y dentro de la persona (opcional)
| Escala X | Escala Y | r entre personas | r dentro de la persona | Acciones |
|---|
Con medidas repetidas, una relación existe en dos niveles que pueden no parecerse, ni en el signo: entre personas (quien escribe más rápido comete menos errores, porque es más hábil) y dentro de la persona (los días que escribe más rápido comete más errores). Las dos escalas deben repetirse con el modelo Interceptos aleatorios y el mismo número de ondas: su estabilidad es la parte de la varianza que es de la persona. En una misma onda, la correlación mezcla los dos niveles; entre ondas distintas solo queda la parte entre personas. El informe verifica las dos correlaciones, la de las medias de cada persona (atenuada con pocas ondas) y la de una sola onda, y dice qué muestran los datos.
Relaciones en el tiempo: rezagada y recíproca (panel cruzado, opcional)
| Tipo | Escala X | Escala Y | r misma onda | Efecto X → Y | Efecto Y → X | ICC X | ICC Y | r interceptos | Acciones |
|---|
Cada onda depende de la anterior: en la rezagada, X de una onda predice a Y en la siguiente más allá de lo que Y ya traía (el efecto X → Y es el β de X controlando la Y anterior); en la recíproca, además, Y predice a X. Las dos escalas deben repetirse con el modelo AR(1) y el mismo número de ondas; su estabilidad sigue siendo la r entre ondas consecutivas, y la parte que no explica el efecto cruzado es la autorregresión. Con efectos cruzados, la r entre ondas lejanas ya no es la estabilidad elevada a la distancia, y las variables que no se repiten se propagan por la misma dinámica. El informe estima los efectos cruzados y los autorregresivos por regresión y dice qué muestran los datos. El panel cruzado supone que no hay diferencias estables entre personas. Con las ICC y la r entre interceptos se convierte en el RI-CLPM (Hamaker, Kuiper y Grasman, 2015): cada persona tiene además un nivel estable (su rasgo) en X y en Y, y la r en la misma onda y los efectos cruzados de la fila pasan a ser los de DENTRO de la persona (la estabilidad de la tabla VI sigue siendo la observada). Si los rasgos se relacionan, el panel clásico ve efectos cruzados que dentro de la persona no existen: el informe muestra lo que estimaría el panel clásico con los datos, la r entre la primera y la última onda (que no decae hacia 0, sino hacia la ICC) y la diferencia con el efecto de dentro. En esta versión, con interceptos, X e Y no se relacionan con otras variables.
Estados con histéresis (opcional)
| Escala | Estado | Bajo | Alto | Entrada (pc) | Salida (pc) | Nitidez (%) | Acciones |
|---|
Un estado de dos valores (por ejemplo, ansiedad clínica: No o Sí) que depende del camino de una escala repetida: se entra cuando la escala supera el umbral de entrada y solo se sale cuando baja del de salida, más bajo; entre los dos (la franja) se conserva el estado de la onda anterior. Así, con la misma puntuación hoy, dos personas pueden estar en estados distintos según de dónde vengan. Los umbrales son percentiles de la escala en T1 (80 y 40 por defecto); la nitidez es el porcentaje de observaciones que no siguen la regla, como en datos reales (5 % por defecto: con 0 la separación sería perfecta y una regresión logística con el estado anterior no convergería). Se crea una columna Estado por onda, calculada sobre las puntuaciones antes de las imperfecciones. El informe verifica la regla y la memoria, y muestra el fenómeno, el bucle (la puntuación media al entrar y al salir) y cuántas personas cambian de estado.
VII. Estructura Factorial de cada test (opcional)
| Ítem |
|---|
Cada fila es un ítem (INV = invertido; su carga se define sobre el ítem recodificado, así que en la base bruta cargará en negativo) y cada columna una dimensión: la celda de su propia dimensión es la carga propia (0.10–0.95); las demás, cargas cruzadas (0 = ninguna). Con «las cargas mandan», el α u ω de cada dimensión queda implícito por las cargas y se muestra debajo; con «el α de la tabla I manda», el patrón se reescala en bloque para cumplirlo. Las correlaciones entre factores son las de la tabla III (o el r intra del test). El informe «pedido vs. obtenido» recupera las cargas por ejes principales, las cruzadas, el factor de método, la fiabilidad implícita, el SRMR frente a la matriz implicada y el KMO con Bartlett. Los ítems de cada dimensión siguen sumando exactamente su total; por eso sus residuos llevan una correlación negativa leve (−1/(k−1)) que con seis o más ítems el AFC no distingue de un modelo puro.
VIII. Desenlaces no continuos y puntos de corte (opcional)
| Escala o puntaje general | Categorías @ cortes | Acciones |
|---|
Crea la columna Nivel_<sigla> con los nombres de las categorías (códigos 1…K en el motor). Cortes fijos: cada corte marca desde dónde empieza la categoría siguiente. Cortes por percentil (P25, P75…): se toman de la muestra generada; con totales enteros los empates en el corte hacen que las proporciones sean aproximadas, y el informe lo indica.
| Nombre | Tipo | Prevalencia / media / categorías | Predictor 1 · OR/IRR | Predictor 2 · OR/IRR | Predictor 3 · OR/IRR | Acciones |
|---|
El efecto es el odds ratio (binario y ordinal) o la razón de tasas (conteo) por cada desviación estándar del predictor: 1 = sin efecto, 2 = duplica la odds, 0.5 = la reduce a la mitad. Los predictores pueden ser escalas, puntajes generales o sociodemográficas continuas; el desenlace se calcula con las puntuaciones verdaderas, antes de las imperfecciones. La prevalencia y las proporciones salen exactas en la muestra; el informe recupera los OR por regresión logística, los IRR por regresión de Poisson y, en el ordinal, el OR de odds proporcionales.
IX. Concordancia entre informantes y jueces (opcional)
| Tipo | Variable | Etiqueta / N.º de jueces | Concordancia (r / κ / CCI) | Sesgo (d) | Acciones |
|---|
El informante crea las columnas de la escala con el sufijo de su etiqueta (ítems, total y percentil), con el mismo
instrumento y la correlación pedida con el autoinforme (exacta en modo exacto); sus correlaciones con las demás variables
quedan atenuadas por esa concordancia y hereda las diferencias por grupo. Los jueces crean columnas Juez1_…,
Juez2_…: en los categóricos cada juez repite la categoría verdadera con probabilidad √κ y si no sortea una
según su frecuencia (el κ resultante es el pedido, sea cual sea la distribución); en los de puntuación, cada juez añade un error
que deja la CCI(1) pedida. El informe compara r, sesgo, κ de Fleiss y CCI con lo pedido.
Para tesis de psicología
AnalizadorEstadístico
Carga tus datos — o usa los del Simulador — y deja que StatSim Pro determine los análisis que necesitas. Obtén resultados explicados en lenguaje claro y genera tu capítulo de resultados en Word con formato APA 7.
Cargar Datos
1. Configuración de la Investigación
2. Configuración de Dimensiones (Opcional)
Análisis Estadístico
Déjala en blanco para omitirla. Si eliges ambas variables, el análisis de regresión (modelo, comparación de formas funcionales y gráfico) se añadirá a los resultados de la correlación y al Word.
Distribución de Puntajes: Teórica vs. Empírica
Matriz de Correlaciones por Variable
Diagrama de Caja
Para tesis de psicología
Buscadorde Antecedentes
Escribe tu tema y busca a la vez en 10 bases académicas — de Google Académico a Scopus, Web of Science y la OMS. Criba los resultados con tus criterios de inclusión y relevancia, y llévate una matriz con referencias APA lista para alimentar tu marco teórico.
Para tesis de psicología
Ejemplosresueltos
Estudios completos hechos con StatSim Pro, de principio a fin: qué se configuró en el Simulador, qué se pulsó en el Analizador y qué salió. Descarga sus archivos —la base en Excel y SPSS, el capítulo en Word, los resultados en PDF— o ábrelos en StatSim para repetirlos paso a paso.
Cargando los ejemplos…
Ayuda y Documentación
Qué hace cada sección y cómo encajan en el flujo de una tesis
🧭 El flujo completo de una tesis
StatSim Pro acompaña las dos mitades del trabajo: la teórica (Buscador → matriz de fuentes → Redactor del marco teórico) y la empírica (Simulador o tus propios datos → Analizador → capítulo de resultados en Word). Cada pieza alimenta a la siguiente.
📂 Ejemplos resueltos
Estudios completos hechos con la propia página (correlacional, comparativo, predictivo, instrumental y con ecuaciones estructurales), con todo lo que entregó: la base en CSV, Excel y SPSS, el capítulo en Word, los resultados en PDF y el proyecto. En la pestaña Ejemplos ves cada caso, descargas sus archivos o lo abres en StatSim para repetir sus pasos: su guía te señala cada control y, si quieres, los hace por ti.
🔎 Buscador de antecedentes
Busca a la vez en Google Académico, Scopus, Web of Science (con una clave de su API), PubMed, SciELO, ALICIA, OpenAlex, Crossref y los repositorios oficiales de la OMS y la ONU. ScienceDirect (en el texto completo de los artículos de Elsevier) está lista, pero viene desmarcada: Elsevier todavía no habilita su API para las claves del sitio. La búsqueda intensiva expande tu consulta con variantes generadas por IA; luego cribas con criterios de inclusión/exclusión y relevancia (1–5) y obtienes una matriz con referencias APA y enlaces.
✍️ Redactor del marco teórico
A partir de tu matriz redacta el Capítulo I (planteamiento y justificación, con un vacío coherente con tu pregunta correlacional) y el Capítulo II (antecedentes con orden internacional → nacional, bases y modelos teóricos con delimitación conceptual anclada a tus instrumentos). Solo cita fuentes reales de tu matriz y descarga en Word (.docx).
🎲 Simulador de datos
Genera bases sintéticas reproducibles (tamaño muestral, semilla y propiedades de cada variable) para practicar todo el flujo sin exponer datos reales — y envíalas al Analizador con un clic.
📊 Análisis estadístico
Protocolo automático de descriptivos, normalidad y correlación (elige Pearson o Spearman según tus datos y te explica por qué); regresión simple y múltiple con comparación de modelos por AIC; comparación de grupos (t, U, ANOVA, Kruskal-Wallis) con ANCOVA y MANOVA opcionales mediante preguntas guiadas; y SEM con sintaxis de lavaan, motor de decisión previo, diagrama de rutas y comparación de modelos.
💡 Pedagogía de los porqués
Cada resultado responde qué es, cómo se interpreta y por qué la estadística funciona así (por qué Spearman usa rangos, por qué el ANOVA compara varianzas, por qué Holm supera a Bonferroni…). El objetivo: que el documento enseñe, no solo reporte.
📄 Exportación Word APA
Capítulo de resultados con tablas y figuras numeradas al estilo APA, y marco teórico en .docx cuyas referencias incluyen solo lo realmente citado. Los datos también se exportan en Excel/CSV.
🔒 Privacidad y funcionamiento
Todo corre en tu navegador: tus datos no se suben a ningún servidor propio. Solo salen las consultas a las bases académicas y, si usas las funciones de IA (variantes, criba, redactor), a la API de Groq con tus claves. La clave de Web of Science, si la pegas, se guarda solo en tu navegador y viaja únicamente a Clarivate (o al relevo propio del sitio).
💾 Proyecto completo
Guardar proyecto descarga un solo archivo (.statsim) con todo tu trabajo: la configuración del Simulador y su base generada (la misma, sin volver a generarla), los datos cargados en el Analizador con sus etiquetas y su configuración de la investigación (el título de la tesis, la unidad de análisis y el lugar), la tabla de la V de Aiken, la última redacción del Redactor y el protocolo de búsqueda con su flujo PRISMA. Abrir proyecto lo devuelve todo a su sitio, en este u otro navegador (te pide confirmarlo antes de reemplazar lo que tengas). No guarda tu clave de Web of Science.
🧹 Si la página no se actualiza
El navegador guarda copias de los archivos del sitio y, tras una actualización, puede mezclar una página nueva con un módulo viejo (la web «se queda» o faltan cosas), incluso después de Ctrl+F5. Recargar sin caché vuelve a descargar todos los archivos del sitio y recarga; no borra nada tuyo. Restablecer y recargar además borra el almacenamiento local: la última redacción del Redactor, la tabla de la V de Aiken, la clave de Web of Science, el ranking de revistas descargado, el estado de los proxies del Buscador y el protocolo y el flujo PRISMA de la sesión (la confirmación dice cuáles hay). En ambos casos, si tienes trabajo a medias, guárdalo antes con Guardar proyecto.
Versiones cargadas (diagnóstico; también en la consola del navegador)
Contacto y Redes Sociales
La persona detrás de StatSim Pro
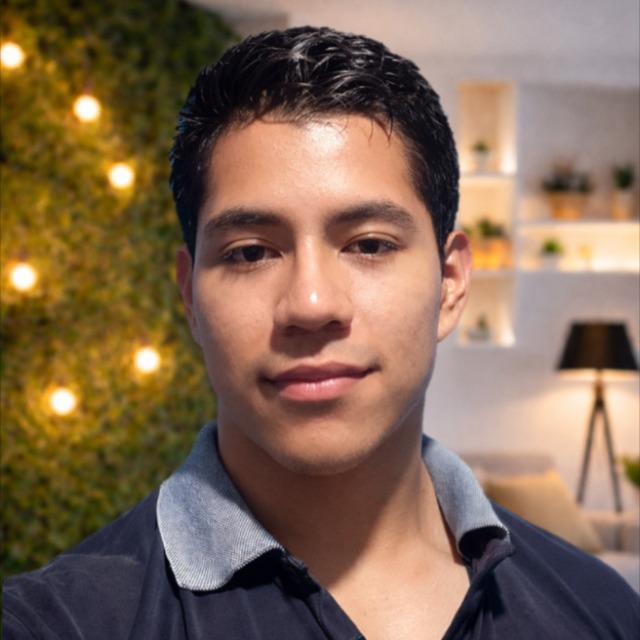
Joel Pasapera
Psicología · Estadística · Divulgación — creador de StatSim Pro
StatSim Pro nació como la herramienta para ser de apoyo en investigaciones de ciencias de la salud y creció hasta convertirse en lo que tienes delante: un laboratorio completo donde la estadística no solo se calcula — se entiende. Lo construyo con un estándar doble: rigor publicable y pedagogía exhaustiva, porque una tesis se defiende mejor cuando puedes explicar el porqué de cada número. Si esta herramienta te ahorra noches de lucha con el SPSS o te enseña algo que ningún manual te explicó, ya cumplió su misión.